
医学影像关键点检测如何突破数据与标注瓶颈?MedSapiens人体姿态基础模型及其跨模态验证
解剖标志点(关键点)检测是影像诊断、手术规划与参数测量的基础,却长期受制于标注数据稀缺、模型难泛化。香港科技大学 Xiaomeng Li 团队提出 MedSapiens,把在 3 亿真人图像上预训练的人体姿态基础模型 Sapiens 迁移到医学影像,配合低秩自适应(LoRA)微调,在 6 项任务、3 种模态上刷新最优成绩——通用模型平均成功率提升 5.26%、专用模型提升 21.81%,超声心动图测量误差下降 43%,为医学影像算法提供了一条数据高效、可迁移的新范式。
解剖标志点(关键点)检测是很多影像任务的第一步:量髋关节角度、判骨龄、做正畸方案、做手术导航,都得先在一张片子上精准定位一批关键点。但长期以来,这项任务被两个老大难卡住——标注数据稀缺、模型换个部位就不灵。2026 年 3 月,香港科技大学 Xiaomeng Li 团队在《Medical Image Analysis》发表 MedSapiens,给出一条反直觉的新思路:借用在 3 亿真人图像上训练的人体姿态模型,来定位医学影像里的解剖关键点。这条路线在 6 项任务、3 种模态上刷新了最优成绩,最高把测量误差砍掉 43%。
研究背景:解剖标志点检测为什么又慢又贵?
解剖标志点检测,指的是在一张医学图像里自动找出一组预定义的解剖点坐标,比如头颅侧位片上的蝶鞍点、手部 X 光上的骨骺点、骨盆片上的髋臼点。这些点是后续一切测量的地基——点不准,角度、长度、分期的结论都会跟着偏。
难点在于两点。第一,高质量的标注极其昂贵:一个解剖标志点需要经验医生逐张逐点标注,跨患者、跨设备、跨部位还各不相同,很难攒出像自然图像那样的大规模数据集。第二,传统方法过度依赖「领域专用先验」:很多模型是围绕特定部位、特定模态手工设计的,换个部位、换种成像方式,往往就得推倒重来,泛化能力差。
这恰恰暴露了一个被长期忽视的机会:定位人体关键点的能力,和定位解剖关键点的能力,本质上是同一件事。既然已经有在千万级真人图像上练出来的姿态估计模型,为什么不直接「借用」它们的空间定位先验?
创新点:MedSapiens如何「借力」人体姿态基础模型?
MedSapiens 的核心主张,用一句话说就是:医学影像关键点检测,不必从零开始。
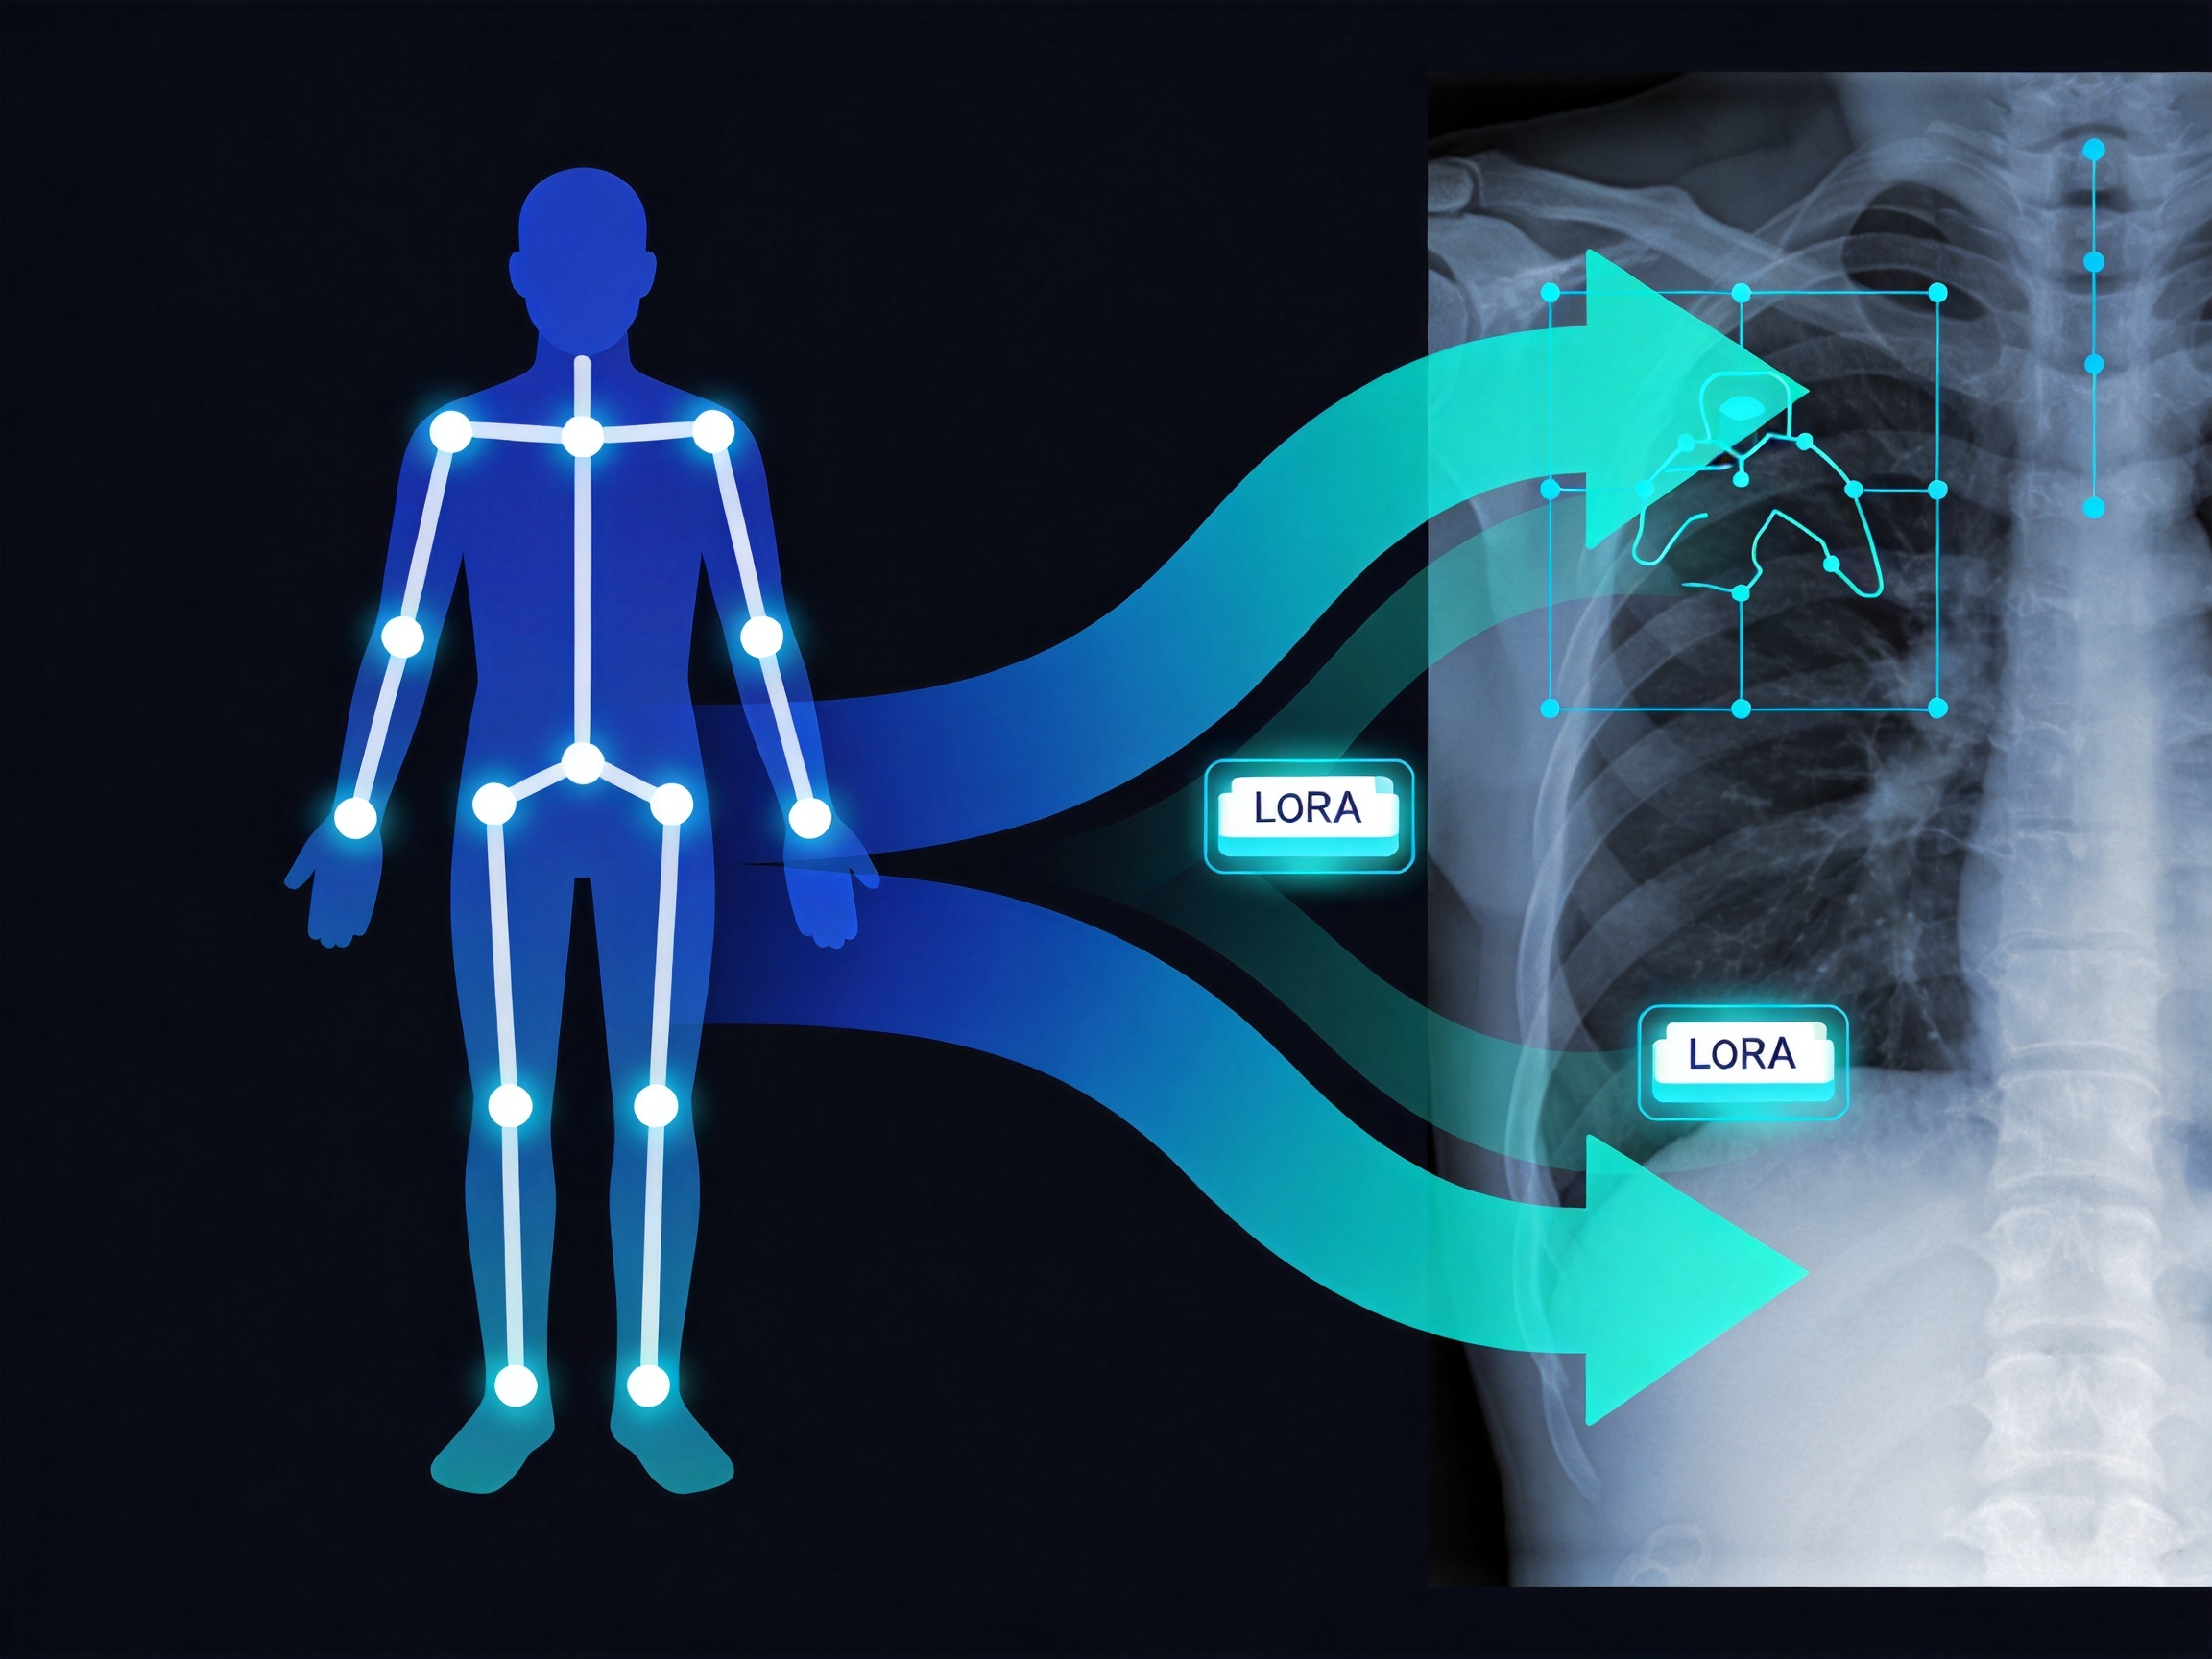
它选用的底座是 Sapiens——一个面向人体姿态估计的基础模型,用超过 3 亿张真实场景人像做自监督预训练,天生就懂「人的关节点之间是什么空间关系」。作者指出,这种姿态先验和医学解剖标志点检测在概念上高度一致:关键点从来不是孤立的,而是按固定的解剖结构相互约束。
基于此,MedSapiens 通过多数据集预训练把 Sapiens 适配到医学影像,并设计了两阶段策略:
- 通用模型(Generalist):在多个部位、多种影像的数据上联合训练,学一套通用的「解剖定位」能力;
- 专用模型(Specialist):在通用模型基础上,针对某一具体任务用 LoRA 再做轻量微调,既保留通用知识,又贴合局部细节。
它并没有发明新架构,而是重新评估了一条被忽视的基线——这也正是这篇工作的价值所在:用最小改动,换来了对领域专用方法的大幅超越。
技术原理:什么是「姿态先验 + LoRA 微调」?
一句话概括:冻结大模型的躯干,只训练几条轻量的「补丁」,让姿态先验落地到解剖结构上。
具体有三层设计:
- Sapiens 主干(0.3B ViT):负责提供强大的空间定位先验,在适配过程中保持冻结,避免海量参数被小数据集「带偏」。
- 低秩自适应(LoRA):只往 Transformer 块里注入几组可训练的低秩矩阵,参数量极小、训练成本低,却能高效地把人体姿态先验「掰」到解剖标志点上。
- 热图解码(Heatmap Head):把主干输出的特征上采样成空间置信热图,再取峰值坐标作为关键点位置,实现亚像素级的精确落地。
训练数据方面,作者整合了 4 个公开数据集——头颅侧位 X 光(正畸分析)、手部 X 光(骨龄评估)、胸部 X 光(肺边界标志点)、下肢 X 光,总计 1,778 张图像、近 4.8 万个标志点,覆盖 6 项任务、3 种影像模态。
数据说话:跨模态验证结果如何?
MedSapiens 在内部基准和外部下游任务上都有清晰提升,核心数字如下:
| 对比对象 | 任务 | 提升幅度 |
|---|---|---|
| 通用模型(vs UniverDetect) | 平均成功检测率 | +5.26% |
| 专用模型(vs NFDP) | 平均成功检测率 | +21.81% |
| 牙科 CBCT(vs GeoSapiens,少样本) | 成功检测率 | +2.69% |
| 超声心动图视频测量(vs 任务 SOTA) | 测量误差(MAE) | −43% |
其中两个外部、未见过的下游任务最能说明泛化能力:在牙科 CBCT 的关键点检测上,MedSapiens 在 0.5 毫米的严格临床容忍度下依然更准;在超声心动图视频测量任务上,其测量误差相比任务专用的最新方法降低 43%,意味着「看 X 光学到的定位能力,能迁移到超声测量」这种跨模态泛化是成立的。此外,在头颅 X 光 2 毫米严格阈值下,MedSapiens 相对提升 8.46%,临床精度更上一层。
应用前景与局限
MedSapiens 的价值在于,它为影像关键点检测提供了一条「数据高效、跨部位可迁移」的新范式:临床科室不必为每个新部位重新标注海量数据、重新训练专用模型,用一个通用底座加少量微调就能快速适配——这对髋关节参数测量、骨龄评估、正畸头影测量、手术导航等场景都有直接吸引力。
但也要冷静看待局限。研究目前主要覆盖 X 光与 CBCT,在 MRI、超声等边界不那么清晰的模态上还需进一步验证;底座只用了 0.3B 的 Sapiens,更大模型(如 2B)是否「更大更强」仍待探索;作者也展望了未来加入文本提示、让医生用自然语言直接「指挥」模型找某个关键点的可能。
结论
解剖标志点检测的「慢」和「贵」,根源在数据稀缺与领域专用先验。MedSapiens 用人体姿态先验 + LoRA 微调证明:医学影像算法不必每换一个部位就从头训一遍,借一个懂「点与点关系」的通用底座,就能在关键点检测上做得更快、更准、更可迁移。它不追求花哨的新架构,却把一个被长期忽视的基线重新做成了新的最优——这或许比一个炫技的模型更值得临床落地参考。
| 论文标题 | MedSapiens: Taking a pose to rethink medical imaging landmark detection |
| 作者 | Marawan Elbatel, Anbang Wang, Keyuan Liu, Kaouther Mouheb, Enrique Almar-Munoz, Lizhuo Lin, Yanqi Yang, Karim Lekadir, Xiaomeng Li |
| 机构 | 香港科技大学(Xiaomeng Li,xmed-lab)、荷兰鹿特丹伊拉斯姆斯大学(Karim Lekadir)等 |
| 期刊 | Medical Image Analysis(医学图像分析) |
| 发表时间 | 2026年3月(在线发表,第111卷) |
| DOI | 10.1016/j.media.2026.104015 |
| PubMed | PMID: 41830658 |
论文原文信息地址:https://www.simomia.com/blog/2026-09-30-medsapiens-landmark-detection/
参考文献
- Elbatel M, Wang A, Liu K, et al. MedSapiens: Taking a pose to rethink medical imaging landmark detection. Medical Image Analysis. 2026;111:104015. DOI: 10.1016/j.media.2026.104015
- Khirodkar R, Bagautdinov T, Martinez J, et al. Sapiens: Foundation for Human Vision Models. European Conference on Computer Vision (ECCV). 2024. DOI: 10.48550/arXiv.2408.12569
相关问题 FAQ
医学影像标志点(关键点)检测是什么?
医学影像关键点检测,是指用算法在一张医学图像上自动定位一组预定义的解剖点坐标,比如头颅侧位片上的蝶鞍点、手部 X 光上的骨骺点、骨盆片上的髋臼点。这些关键点是后续测量(角度、长度)、分期(如骨龄)和手术规划的「地基」——点定位得准不准,直接决定后续结论是否可靠。它也是髋关节参数测量、正畸头影分析、手术导航等场景共有的基础步骤。
用人体姿态模型做医学影像关键点检测,靠谱吗?
靠谱,而且这正是 MedSapiens 的核心洞见。人体姿态估计模型在千万级真人图像上学到的,是「关键点之间固定的空间关系」这种通用定位先验;而解剖标志点同样不是孤立的,而是受解剖结构相互约束。作者把在 3 亿真人图像上预训练的 Sapiens 迁移到医学影像,再配合低秩自适应(LoRA)微调,结果在 6 项任务、3 种模态上超过了此前的通用模型(+5.26%)和专用模型(+21.81%),并成功泛化到牙科 CBCT 和超声心动图测量等未见过的任务上。
MedSapiens 会取代医生手工标注与测量吗?
不会。MedSapiens 的价值是帮医生减少重复性的手工定位与测量负担,让关键点检测更快、更一致、更可迁移;它目前主要覆盖 X 光与 CBCT,在 MRI、超声等边界不清晰的模态上仍需进一步验证,最终临床判断和测量复核仍由医生把关。它的定位是辅助工具,而不是替代医生。
📄 论文原文信息
| 论文标题 | MedSapiens: Taking a pose to rethink medical imaging landmark detection |
| 作者 | Marawan Elbatel, Anbang Wang, Keyuan Liu, Kaouther Mouheb, Enrique Almar-Munoz, Lizhuo Lin, Yanqi Yang, Karim Lekadir, Xiaomeng Li |
| 期刊 | Medical Image Analysis, 2026 |
| 发表时间 | 2026年3月(在线发表,第111卷) |
| DOI | 10.1016/j.media.2026.104015 |
| PubMed | PMID: 41830658 |