
脑部病灶AI诊断报告怎么自动生成?SAMSeeK分割与视觉语言模型融合方法解读
脑MRI病灶分割与自动诊断报告生成长期各自为战。SAMSeeK把SAM 2分割、Hilbert曲线引导的Mamba空间建模与Qwen 2.5-VL视觉语言模型融进一个框架,在BraTS2021上分割Dice达82.4%,病灶分型准确率81.2%,并生成4800份带定量描述的报告,实现「分割—定量—报告」一步到位。
脑部病灶(如胶质瘤、脑梗死、癫痫相关病灶)的影像诊断,长期卡在「分割」和「报告」两件事各自为战的局面:分割模型能把病灶轮廓勾出来,但给不出临床医生真正要的那份文字报告;报告生成模型能写出文字,却又常常脱离影像证据、甚至凭空编数字。发表在《Frontiers in Neurology》上的 SAMSeeK 框架,把两者焊进同一条流水线,用「先定量、后成文」的思路,让报告里的每一个数字都有影像依据可查。
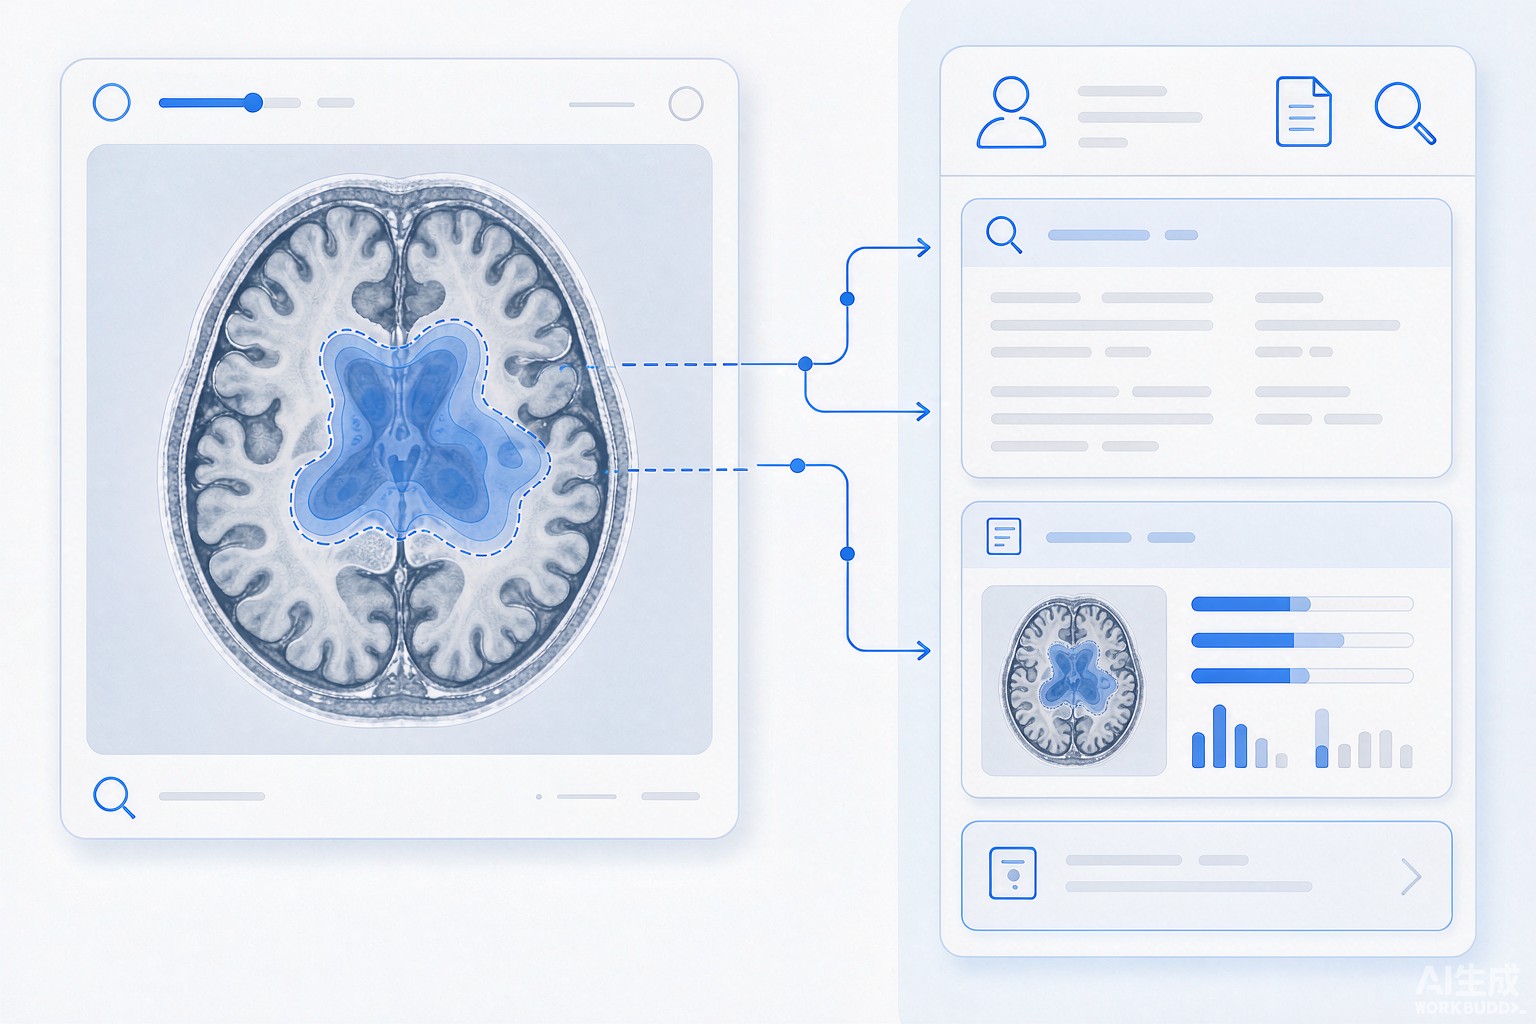
研究背景:脑部病灶的诊断报告为什么难自动化?
中枢神经系统病灶的诊断报告,本质上是一份「定量 + 定性」的证据清单:病灶体积多大、在哪个坐标、累及范围如何,再据此给出分型判断。病灶往往形态不规整、边界模糊,且容易与背景组织混在一起,传统视觉模型容易「看走眼」,把背景误判成病灶。
这也是很多医学影像大模型(视觉语言模型,VLM)的通病——它们直接做端到端的「图→文」映射,中间没有经过显式监督的病灶属性建模,导致生成的报告里数字和文字「漂」在影像之外,临床上难以采信。如何让报告既准又有据可查,是脑影像 AI 落地的一个硬问题。
创新点:SAMSeeK 如何把「分割、定量、报告」串成一条线?
SAMSeeK 的答案是把三件事揉进一个统一框架:
- 几何感知的视觉编码器 + 大视觉语言模型:先用一个几何感知编码器理解病灶的空间结构,再交给大 VLM 做语义推理。
- Hilbert 曲线引导扫描的 Mamba 架构:针对脑病灶空间分布不均、位置散乱的问题,用希尔伯特曲线(Hilbert curve)把二维切片铺成一条保留局部邻接关系的序列,再送进 Mamba 状态空间模型,增强对病灶「局部—全局」上下文的感知。
- 结构化提示增强机制:把分割得到的**定量病灶属性(体积、空间坐标、像素级范围)**直接注入 Qwen 2.5-VL 的提示词,让模型「先知道数字、再写句子」,而不是凭空编。
一句话概括它的机制:用 SAM 2 系分割模型把病灶精确定位并量化,再用定量属性驱动大模型写报告,报告因此有了可回溯的影像证据链。
技术原理:为什么是「先定量、后成文」?
SAMSeeK 的核心思路可以拆成两步。
第一步是空间定位。它改造了 SAM 2 的编码器和解码器,引入 Hilbert 曲线引导的扫描方式,让模型在遍历切片像素时天然保留空间邻接关系,从而更准确地框出病灶区域。这一步解决了「背景干扰导致的误分类」这个老问题。
第二步是证据落地。分割完成后,模型计算病灶的体积、坐标、像素范围等确定性(deterministic)的定量指标,把这些数字作为结构化提示注入 Qwen 2.5-VL。大模型不再「看图估数字」,而是把已经算好的数字组织成符合临床规范的文字描述。
这一「分割产出数值、数值驱动成文」的设计,让报告里的关键数字与影像一一对应,降低了视觉语言模型凭空编造数值的风险。
数据说话:分割与分型双双达到新水平
研究用 4,800 张二维脑 MRI 切片训练和评估,覆盖三大类病灶:胶质瘤(glioma)、癫痫(含局灶性皮质发育不良,FCD)、脑梗死(cerebral infarction),并在三个公开基准上验证。
| 任务 | 指标 | SAMSeeK 结果 |
|---|---|---|
| 病灶分割(BraTS2021) | 平均 Dice 系数 | 82.4% |
| 病灶分割(BraTS2021) | 平均 IoU | 73.5% |
| 病灶分型 | 准确率 | 81.2% |
| 病灶分型 | F1 分数 | 0.852 |
在分割任务上,SAMSeeK 在 BraTS2021 上取得 82.4% 的平均 Dice,显著超过现有方法;在病灶分型上达到 81.2% 准确率、83.9% 召回率、F1 0.852。基于这套「分割 + 分型」能力,模型成功生成了 4,800 份带定量病灶描述、临床可用的诊断报告。
应用前景与局限
SAMSeeK 的价值在于给出了一条「分割—定量—报告」端到端、且可解释、可回溯的脑影像报告生成路线,对神经影像的科研与临床流程都有参考意义。
但它也有明确的边界:训练和验证主要在二维切片层面,尚未覆盖完整的三维容积分析;病灶类型目前只覆盖胶质瘤、癫痫、脑梗死三类,样本规模也相对有限。论文作者也强调,要真正进入临床常规,还需要更大规模、多中心的真实世界验证。
结论
SAMSeeK 把脑部病灶的分割、定量分析与报告生成整合进一个统一框架,用「先算准数字、再写成报告」的思路,缓解了视觉语言模型在影像报告中常见的「脱离证据、凭空生成」问题。它在 BraTS2021 上取得 82.4% 的 Dice,病灶分型准确率 81.2%,并产出 4,800 份带定量描述的报告,展示了「分割 + 大模型」融合用于临床神经影像的可行路径。
相关问题
问:脑部病灶自动分割和报告生成能一步完成吗?
答:可以。SAMSeeK 把 SAM 2 分割、Hilbert 曲线引导的空间建模与 Qwen 2.5-VL 视觉语言模型融合,先完成病灶分割与定量测量,再用定量属性驱动报告生成,实现「分割—定量—报告」一步到位。
问:视觉语言模型生成的影像报告会不会凭空编数字?
答:SAMSeeK 专门针对这个问题设计。它不直接让大模型「看图估数字」,而是先由分割模型确定性计算出病灶体积、坐标、像素范围等指标,再把这些数字注入提示词,让报告里的关键数值有影像依据可查。
论文原文信息卡片
| 论文标题 | SAMSeeK: Nervous Centralis Lesion Diagnostic Report Generation via SAM 2 and Vision-Language Models |
| 作者 | Tian, Wang, Kang, Yang, Yang, Xu and Xue(通讯作者 Bi Xue) |
| 期刊 | Frontiers in Neurology |
| 发表时间 | 2026-10-26 |
| DOI | 10.3389/fneur.2026.1979682 |
| PubMed | — |
论文原文信息地址:https://www.simomia.com/blog/2026-11-16-samseek-cns-lesion-report-generation/
参考文献
- Tian, Wang, Kang, Yang, Yang, Xu, Xue. SAMSeeK: Nervous Centralis Lesion Diagnostic Report Generation via SAM 2 and Vision-Language Models. Frontiers in Neurology, 2026. https://doi.org/10.3389/fneur.2026.1979682
📄 论文原文信息
| 论文标题 | SAMSeeK: Nervous Centralis Lesion Diagnostic Report Generation via SAM 2 and Vision-Language Models |
| 期刊 | Frontiers in Neurology |
| 发表时间 | 2026-10-26 |
| DOI | 10.3389/fneur.2026.1979682 |